2026年のビジネス向けAIモデルの中から選択する際には、単にベンチマークスコアが最も高いモデルを選ぶというわけにはいきません。サポートチームはスピードと低コストを必要とするかもしれませんが、ソフトウェアチームはリポジトリレベルのコーディングを必要とし、プライバシー重視のビジネスはオープンモデルまたはローカル展開モデルを好むかもしれません。.
GPT-5.6, クロード, Gemini、Grok、GLM、DeepSeek、Qwen、MiniMaxをはじめとするモデルファミリーは、それぞれ異なるワークロードをリードしています。推論やコーディングに優れているものもあれば、マルチモーダル作業、レイテンシ、価格、ツール使用、プライベートデプロイにおいて際立っているものもあります。.
同じモデルでチャットボット、コパイロット、または AIエージェント それを取り巻くツール、メモリ、権限、ワークフローによって異なります。真の決定は、どのモデルが最も能力が高いかだけでなく、どのモデルがタスクを確実かつ安全に、持続可能なトータルコストで完了できるかということです。.
このガイドでは、ワークロード、ベンチマーク証拠、コスト、セキュリティ、デプロイメントオプション、ローカル利用、チャットボットおよびAIエージェントワークフローのサポート別に、ビジネスに最適なAIモデルを比較します。.
| 調査メモ |
| リサーチのカットオフ:2026年7月11日。モデルのエイリアス、プレビューアクセス、価格、リーダーボード、データ保持期間、および地域ごとの利用可能性は変更される可能性があります。購入またはデプロイの前に、リンクされた公式ページを再確認してください。. |
2026年、すべてのビジネスにとって単一の「最良」のAIモデルというものは存在しません。最も強力な選択肢はワークロードによって異なります。
費用は大きく異なります。報告書の例では 100万トークン入力+25万トークン出力, 、トークンのみの推定コストは、約 $0.62 ~ $22.50, 検索、ツール、リトライ、監視、または人間のレビューの前。.
ほとんどのビジネスでは、あらゆるタスクに最も強力なモデルを必要としません。ルーティングされたセットアップでは、日常的な作業には低コストのモデルを使用し、困難な場合やリスクの高い場合には最先端のモデルを予約しておくことができます。.
あるサポートシナリオでは、80%の会話のルーティングを ジェミニ 3.1 フラッシュライト そして、残りの 20% を GPT-5.6 ソル トークン単体の推定コストを、約$275から$66、つまりおよそ76%に削減しました。実際の削減額は、会話の長さ、ルーティングの精度、再試行回数、使用するツール、および人間によるレビューによって異なります。.
AIモデルは推論エンジンであり、「チャットボット」や「エージェント」はそれを囲むシステムを指します。チャットボットでは、AIモデルが主にメッセージに応答します。AIエージェントでは、ツール、タスクの状態、権限、そして作業を進めることができる制御ループに接続されています。.
一つのツールを一度呼び出しただけでは、システムが自動的にエージェントになるわけではありません。複数のアクションを選択・順序立てて実行し、結果を確認し、次のステップを調整し、必要に応じて停止または承認を求めることができるようになったときに、それがエージェントへと移行します。.
このグラフは、2026年における主要なAIモデルの近接性を示しています。Claude Fable 5が60点でトップを占め、GPT-5.6 Solが59点でそれに続いています。.
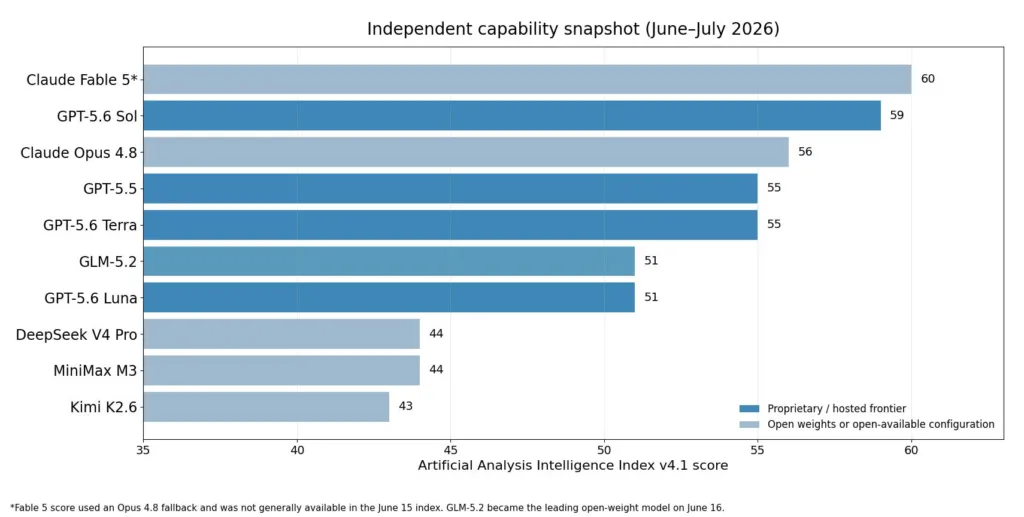
ソース: 人工分析. 高いほど良い.
ビジネスにおいて、ベンチマークは出発点として最も役立ちます。Fable 5 および GPT-5.6 Sol は、高性能ショートリストに含めるべきです。.
テラ、ルナ、, GLM-5.2, コスト、速度、プライバシー、または展開の柔軟性が最高のスコアよりも重視される場合は、DeepSeek V4 ProやMiniMax M3の方が適している場合があります。.
ベンチマークは正しい方向を示すことができますが、それでモデルを決定すべきではありません。最良の選択肢は、実際のワークフロー内で良好なパフォーマンスを発揮し、誤りを低く抑え、手作業での修正の必要性を減らし、ビジネスにとって合理的なコストで結果をもたらすものです。.
このリーダーボードは、客観的に最も正確なモデルではなく、実際の会話で人々が好んだAIモデルを示しています。.
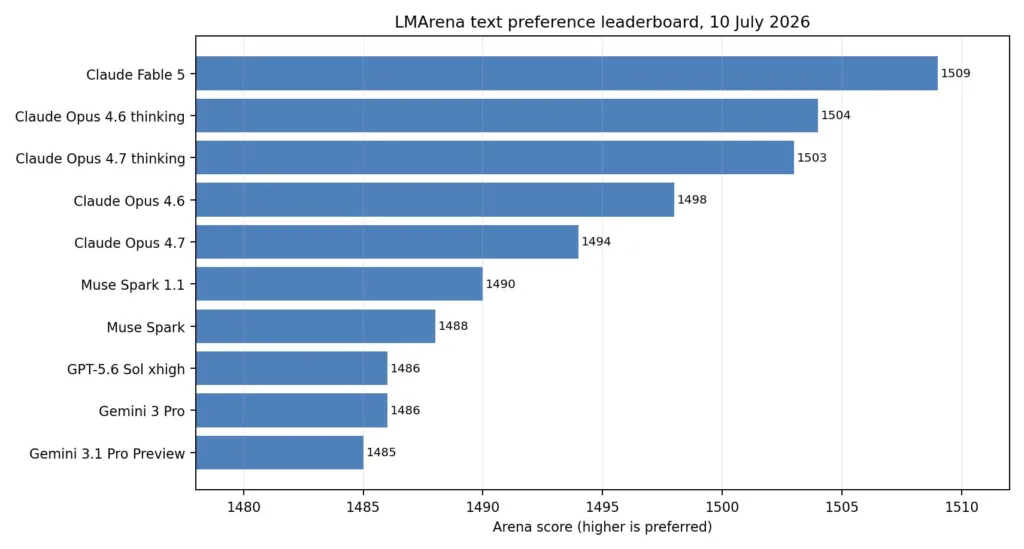
ソース: LMArena テキストリーダーボード. 人間の好みは、有用性、スタイル、そして提示方法を含みます。.
スナップショットでは、Claude Fable 5 が 1509 点でリードしていました。いくつかの Claude Opus バージョンが僅差で続いており、GPT-5.6 Sol と Gemini 3 Pro は両方とも 1486 点でした。.
顧客対応の業務においては、それが重要となります。回答が明確で、役に立ち、自然で、分かりやすいかどうかを人々は注意深く見ています。ここでうまく機能するモデルは、サポート、営業会話、ライティング、その他のユーザー対応タスクの強力な候補となり得ます。.
しかし、好みは全体像の一部にすぎません。高いアリーナスコアは、モデルがより事実に基づいている、より安全である、ツールをよりうまく使用できる、またはビジネスワークフロー内でより信頼性が高いことを証明するものではありません。新しいモデルは投票数が少ない場合もあり、不確実性の範囲が重なる場合、スコアのわずかな違いはあまり意味をなさない可能性があります。.
このチャートの最良の使い方は、カスタマーエクスペリエンスのテストに値するモデルを特定することです。.
ソフトウェア、ハードウェア、またはエンジニアリング分野の企業にとって、このスナップショットは、技術的な作業でテストする価値のあるAIモデルを絞り込むのに役立ちます。.
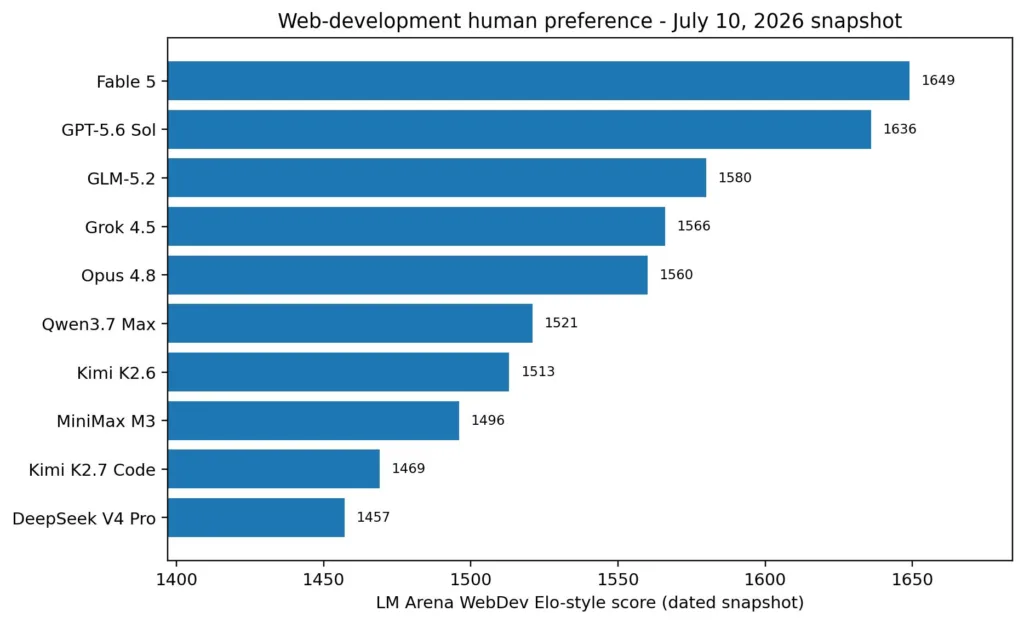
ソース: LMArena WebDev リーダーボード. GPT-5.6行はCodexハーネスを使用しました。したがって、スコアはモデルと周囲のコーディングシステムを反映しています。.
最近の結果では、Fable 5が1649点で1位となり、次いでGPT-5.6 SolとGLM-5.2が1580点で3位となり、Grok 4.5とClaude Opus 4.8を上回りました。.
これにより、Fable 5 と GPT-5.6 Sol は、複雑な開発タスクの強力な候補となります。 GLM-5.2 プライベートコーディングやエージェントワークフローのオープンウェイトオプションを探しているチームは注目すべきです。.
しかし、これは完全なエンジニアリングベンチマークではありません。GPT-5.6の結果はCodexハーネスを使用したため、スコアはモデルと周囲のコーディングシステムの Сbothを反映しています。人間の好みは、コードが正しいか、安全か、本番環境Readyかだけでなく、最終出力がどれだけ便利で洗練されているかを測定します。.
ソフトウェア企業、WordPressチーム、SaaS製品、ハードウェアビジネス、エンジニアリングファームにとって、次のステップとしてより良いのは、プライベートな技術テストです。リポジトリの変更、API、ファームウェアサポート、技術文書、デバッグ、SQL、セキュリティチェック、テスト生成、下位互換性など、チームが実際に行う作業に基づいて、各モデルを比較してください。.
ブランド名だけでAIモデルを選ぶのは魅力的ですが、企業はベンチマークを買っているのではありません。彼らは成果を買うのです。.
カスタマーサポートチームには、迅速な応答と安全なエスカレーションが必要です。ソフトウェアチームには、リポジトリへのアクセス、テスト、および信頼性の高いコード変更が必要です。プライバシーを重視する企業は、公開リーダーボードで勝利することよりも、セルフホスティングを重視するかもしれません。そのため、最も有用なショートリストは、モデルに完了させたい作業から始まります。.
以下の表は、公式モデルのドキュメント、価格ページ、および独立したベンチマーク証拠に基づいた実用的な出発点を提供します。これはテストのショートリストであり、普遍的なランキングではありません。.
| ビジネスニーズ | 開始の選択肢 | 最適 | 主な注意事項 | 主要な情報源 |
| 最大限の一般能力 | クロード・フェイブル5かGPT-5.6ソル | 複素解析、高付加価値研究、そして困難な計画 | どちらもプレミアムな選択肢です。コミットする前に、実際のタスクでテストしてください。. | 人工解析では、フェイブル5と GPT-5.6 ソル インテリジェンス・インデックスにおいて、互いに近い. |
| バランスの取れたエンタープライズエージェント | GPT-5.6 Terra, Claude Sonnet 5、または Gemini 3.5 Flash | 日常的な知識労働、ツールの活用、マルチモーダル入力、標準的なビジネス自動化 | 低コストモデルは、困難または機密性の高いケースではエスカレーションが必要になる場合があります。. | OpenAIは、Terraをバランスの取れたものとして位置づけています GPT-5.6 GoogleはGemini 3.5 Flashをマルチステップのエージェントワーク向けモデルと説明し、AnthropicはSonnetをバランスの取れたモデルティアとして位置付けています。. |
| 大量サポートとルーティング | ジェミニ 3.1 フラッシュライト、GPT-5.6 ルナ、またはクロード・ハイキュー 4.5 | 分類、抽出、チケットトリアージ、および簡単な定型応答 | 苦情、返金、アカウント変更については、より強力なモデルまたは人間のレビューを追加してください。. | Googleは説明しています フラッシュライト OpenAIはLunaを低レイテンシーで大量ワークフロー向けのコスト効率の高いティアとして位置づけており、AnthropicはHaikuを高速でコスト重視のアプリケーションに推奨しています。. |
| リポジトリレベルのコーディング | GPT-5.6 Sol (Codex搭載); Claude FableまたはOpusをレビュー担当 | 大規模なコードベース、ターミナル操作、テスト、デバッグ、コードレビュー | 周囲のコーディングエージェント、ツール、テストポリシー、および推論予算は結果を変更する可能性があります。. | GPT-5.6 Solは、Codexハーネスで捕獲された人工分析コーディングエージェントインデックスを率いた。. |
| マルチモーダル文書とメディア | ジェミニ 3.1 Pro または ジェミニ 3.5 Flash | PDF、画像、音声、動画、ファイル、コードを含むワークフロー | 正確なエンドポイント、ツールの料金、コンテキスト制限、およびデータガバナンストームを確認してください。. | Googleリスト ジェミニ 3.1 プロ 複雑なマルチモーダル推論のため、および大規模なエージェント・コーディングタスクにはGemini 3.5 Flash。. |
| オープンまたはプライベートエンタープライズ展開 | GLM-5.2、Mistral Large 3、または Command A+ | オンプレミス、プライベートクラウド、ソブリン、またはカスタマイズされたデプロイメント | あなたのチームは、インフラストラクチャ、セキュリティ、監視、およびアップデートを担当します。. | GLM-5.2 Mistral Large 3とCommand A+は、プライベートデプロイメント用にApache 2.0ライセンスでリリースされており、ロングコンテキストサポートが利用可能です。. |
| 低コストオープン推論 | DeepSeek V4 Pro または V4 Flash | 繰り返し推論、コーディング、ツール呼び出し、コストを意識したエージェントタスク | モデルはまだ自己ホストするには大きすぎ、地域アクセスまたはデータ条件の確認が必要です。. | DeepSeekの 公式リリースでは、V4 ProとFlashが長文コンテキスト推論およびエージェントモデルとして説明されており、Flashはより小さく安価なオプションとして設計されています。. |
| 中国語と英語のビジネスワークフロー | Qwen3.7 Max、GLM-5.2、Kimi K2.6、またはDeepSeek V4 | 多言語オフィスワーク、コーディング、長文コンテキストタスク、ツールベースのワークフロー | 国際エンドポイントへのアクセス、モデルバージョン、所在地、モデレーション、請求、サポートを確認してください。. | Alibabaが推奨 Qwen3.7 Max 複雑な多段階タスク。Z.ai、Kimi、DeepSeekは、エージェンティック、コーディング、および長期間の機能を文書化しています。. |
| ローカルワークステーションアシスタント | Qwen3-Coder、Gemma 4 12B、Ministral 3 14B、またはDevstral Small 2 | プライベートリポジトリ、オフラインドキュメント、ローカルコーディング、クラウドへの露出低減 | 実際のパフォーマンスは、RAM、GPUメモリ、量子化、コンテキストサイズ、ランタイムサポートに依存します。. | Qwen3-Coder リポジトリ規模のコーディングをサポートし、Gemma 4は12Bのオープンモデルを含み、Ministral 14Bはローカル使用に最適化され、Devstral Small 2はローカルソフトウェアエンジニアリングエージェントを対象としています。. |
適切な選択は、ビジネスが処理する必要がある特定のワークロードによって異なります。低コストのオプション(例: ジェミニ・フラッシュライト、GPT-5.6ルナ、, と クロード・ハイキ ルーチンサポート、チケットの仕分け、および簡単なデータタスクを処理できます。.
営業、CRMの更新、日々の業務において, テラ、ソネット、, と ジェミニ・フラッシュ 性能、速度、コストのより良いバランスを提供する.
ソフトウェア開発、技術調査、長文分析などのより要求の厳しい作業には GPT-5.6 ソル、クロード、ジェミニ プロ、GLM-5.2, または Qwen3-Coder. より厳格なプライバシー要件を持つチームは、オープンソースまたはセルフホスト型のオプションも検討できます。.
ほとんどのビジネスは、すべてに1つのモデルを必要とするわけではありません。混合設定の方が通常はうまく機能します。定型業務には低コストのモデルを使用し、困難なケースはより強力なモデルに送り、払い戻し、アカウント変更、外部メッセージ、その他の機密性の高いアクションの前に人間の承認を維持します。.
モデルだけでなく、完全なAIアシスタントを比較したい企業は、当社のガイドをご覧ください。 最高のChatGPTの代替案.
はい。オープンウェイトAIモデルは、ラップトップ、ワークステーション、またはプライベートサーバーで実行できます。ローカルAIモデルをローカルAIエージェントにするには、エージェントランタイム、プライベートメモリまたはRAG、およびファイル、ブラウザ、ターミナル、ビジネスアプリケーションなどのツールへの制御されたアクセスを追加します。.
主な利点は、制御です。機密ファイルやプライベートリポジトリは、ご自身の環境内に保持できます。図は、ユーザーのリクエストがローカルエージェントランタイムを経由して、ローカルモデル、プライベートナレッジインデックス、サンドボックス化されたツールにどのように渡されるかを示しています。.
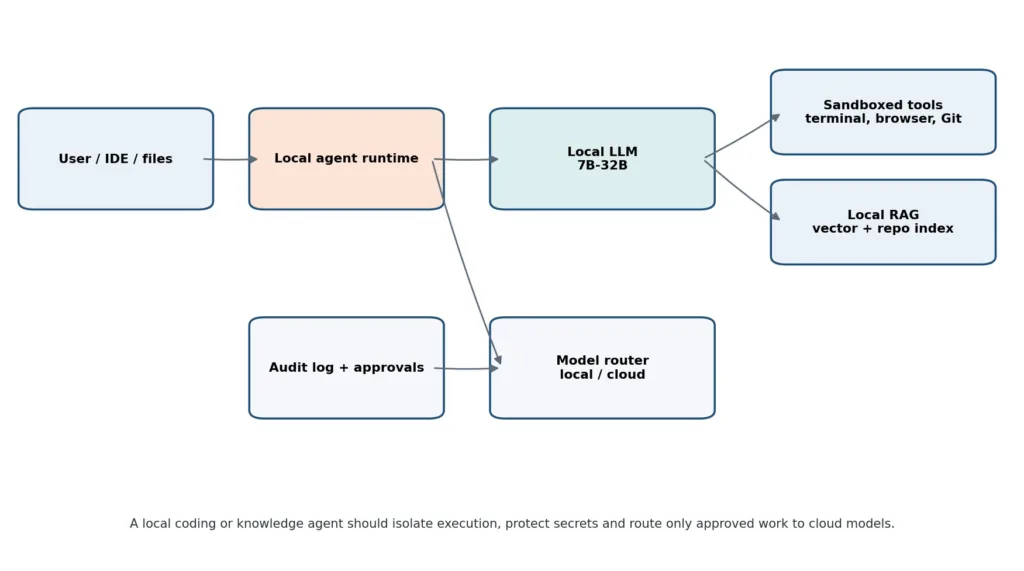
ソース: llama.cpp プロジェクト. リポジトリへのアクセスはローカルに限定し、ターミナルとブラウザの実行を隔離し、承認されたコンテキストのみをクラウドフォールバックに送信します。.
このセットアップにはいくつかのモデルが適合します。. ジェマ 4 12B と MiniStrall 3 8B または 14B 文書検索、プライベートアシスタント、および一般的なツール利用のための実用的な選択肢です。.
デブストラルト小型2 24B リポジトリベースのコーディング作業のために設計されています。一方、小規模な Qwen モデルはローカルコーディングや中英タスクをサポートできます。. グラナイト 4.1 8B 民間企業向け検索および RAG および Phi-4 推論 ビジョン 15B ドキュメント、画像、インターフェイス関連のタスクを処理できます。.
より小さなモデル、例えば ジェンマ 4 E2B/E4B または Llama 3.2 1B/3B 電話や軽量デバイスで、簡単なオフライン作業を実行できます。.
正しい選択は〜にかかっています 使用可能なRAM、GPUメモリ, モデルの量子化、コンテキスト長、およびチームが期待する速度。小規模なモデルは実行が容易ですが、コーディングや長文のドキュメント処理にはより強力なワークステーションが必要になる場合があります。.
ローカルデプロイメントは機密データを管理下に置きますが、それでもセキュアなツールアクセス、アップデート、監視、監査ログ、サンドボックスが必要です。.
多くの企業にとって、ハイブリッド設定が最適です。プライベートでルーチンワークはローカルに保ち、承認された難易度の高いタスクのみをクラウドモデルに送信します。.
APIの価格は単純に見えるかもしれませんが、それは出発点にすぎません。ビジネスワークロードは、ウェブ検索、ブラウザーセッション、コードサンドボックス、ベクトルデータベース、外部ツール、リトライ、フォールバックモデル、監視、および人間のレビューを使用することもできます。.
だから、企業は、100万トークンあたりの価格だけでなく、成功したタスクあたりの総コストを測定すべきなのです。.
以下のグラフは、1つの共通の例を使用しています。 100万トークン入力+25万トークン出力. それらの仮定の下では、トークンのみの推定コストは $0.62(Gemini 3.1 Flash-Lite 搭載) 〜へ $22.50(『クロード・フェイブル』第5巻), 35倍以上の差.
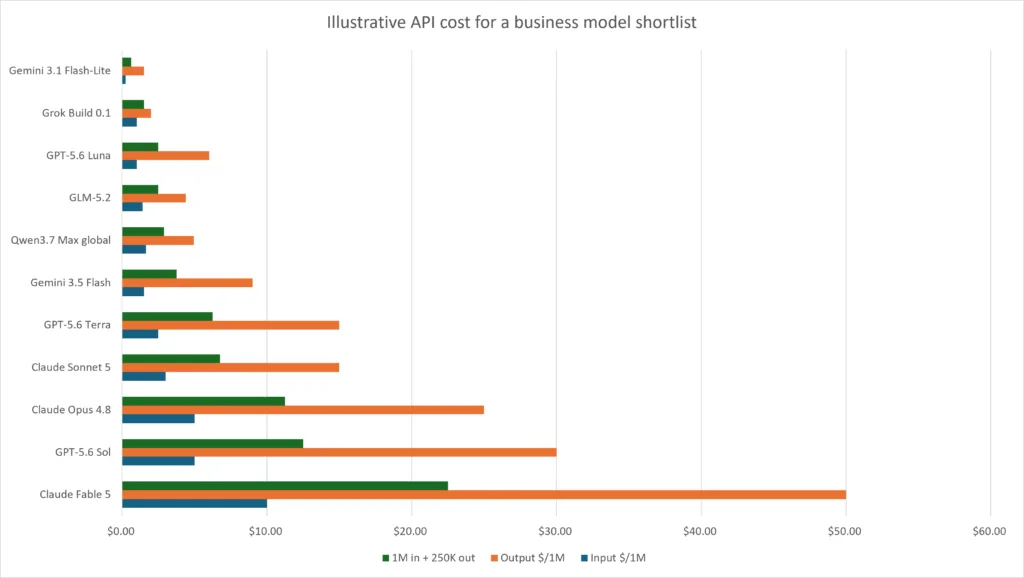
上記の料金表は、特定のベンダーの主張ではなく、公式のプロバイダー料金を使用しています。.
最近のユーザー事例は、もう一つの有用なシグナルを提供しています。開発者のDaxは、Claude Fableが約 彼のチームのモデルのコスト「30%」, スクリーンショットではGPT-5.6 Solよりもはるかに低い使用率が示されていたにもかかわらず、サム・アルトマンは後に返信でその違いを強調しました。.
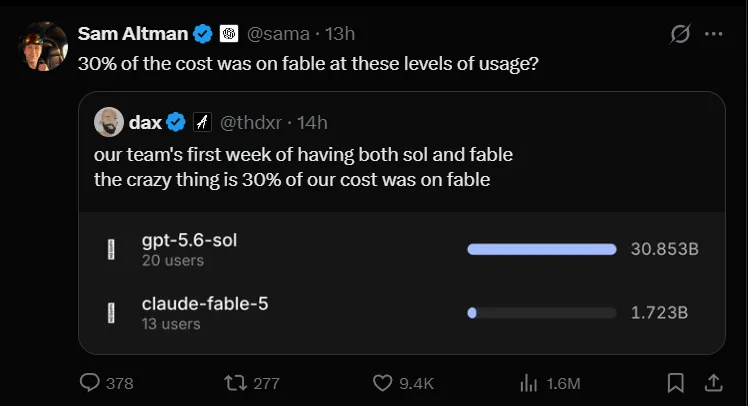
この例は〜として扱われるべきです 個人的な観察であり、統制されたベンチマークではありません. 2つのモデルは、異なるタスク、プロンプト、出力長、推論設定、またはワークロードを処理した可能性があります。.
しかし、それでも重要な点を改めて強調しています。トークン価格と利用量では、請求額が大きく異なる可能性があります。同じタスクでモデルを比較し、全体を測定してください。 成功報酬単価, リトライや人間のレビューを含め.
すべてのビジネスプロセスにAIが必要なわけではありません。手順が予測可能で固定されている場合、通常は固定自動化の方が速く、安価で、制御しやすいです。AIは、ワークフローが解釈、判断、変更される決定、または予期しない状況の処理を必要とする場合に価値を発揮します。チャットボット、エージェント、またはモデルを選択する前に、AIが応答時間、精度、リードの質、または完了した作業などの測定可能な結果を改善するかどうかを尋ねてください。数回のクリックを置き換えるだけの場合、自動化で十分かもしれません。.
ビジネス向けのAIモデルを比較する際、単にベンチマークで最も成績の良いモデルを選ぶのが正解ではありません。重要なのは、実際のワークロードを安全、確実、そしてビジネスが維持できるコストで完了できるモデルです。.
FableとGPT-5.6 Solはフロンティア・ショートリストに含めるべきです。Terra、Sonnet、Gemini Flash、Luna、Flash-Liteは、日常的なコストの管理をさらに強化します。GLM、DeepSeek、Qwen、MiniMax、Mistral、Command A+は、オープン、プライベート、ローカル、およびリージョナル展開の柔軟性を高めます。.
1. 定義されたワークロードから開始します。 2. 予測可能なステップはルールベースに保ち、モデルには必要なツールのみを与え、機密性の高いアクションの前に人間の承認を要求します。 3. 次に、タスクの成功、エラー、レビュー時間、速度、および完了した成果ごとの総コストを測定します。.
自動化やAIエージェントのワークフローを構築するチームにとって、Bit Flowsのようなプラットフォームは、選択したAIモデルをトリガー、ビジネスルール、アプリケーション、承認プロセス、ログと連携させることができます。その目的は、すべてのステップにAIを導入することではなく、解釈や判断が真の価値を生み出す場面にのみ、適切なモデルを活用することにあります。.
単一の勝者はいません。ビジネスにとって最適なAIモデルは、ワークロード、予算、プライバシー要件、ツール、デプロイ方法、許容されるエラー率によって異なります。.
GPT-5.6 Terra、Claude Sonnet 5、Gemini 3.5 Flash は、日々のナレッジワーク、CRMタスク、コンテンツ作成、ビジネス自動化を始めるための実用的な選択肢です。.
Gemini Flash-Lite、GPT-5.6 Luna、Claude Haikuはルーチンサポートに適していますが、苦情、返金、アカウント変更については、より強力なモデルまたは人的レビュアーに移行させるべきです。.
ChatGPT SolとClaude Opusは複雑なリポジトリ作業の有力候補であり、GLM-5.2とQwen3-Coderはプライベートコーディングワークフロー向けのオープンウェイトオプションを提供します。.
Gemini ProとGemini Flashは、ドキュメント、画像、音声、動画、ファイル、コードを含むマルチモーダルワークフローの強力な出発点となります。.
はい、同じモデルでも、その周辺に構築されるツール、メモリ、権限、ワークフローによって、チャットボット、コパイロット、AIエージェントとして機能させることができます。.
ほとんどのビジネスでは、定型業務には低コストのモデルを使用し、複雑、不明確、または機密性の高いケースにはより強力なモデルまたは人間のレビューを使用するなど、モデルルーティングから利益を得ています。.
総コストには、トークン、検索、ツール、ストレージ、サンドボックス、リトライ、監視、レビューが含まれるため、企業は成功したタスクあたりのコストを測定すべきです。.
総コストには、トークン、検索、ツール、サンドボックス、ストレージ、リトライ、監視、人間のレビューが含まれるため、企業はトークン価格だけでなく、成功したタスクごとのコストを比較する必要があります。.
はい、オープンウェイトモデルはローカルで実行でき、量子化された7B〜32Bモデルはローカルドキュメント、コーディング、検索、および狭いツールをサポートできますが、ハードウェア、セキュリティ、アップデート、コンテキスト長、実行時パフォーマンスは依然として重要です。.
管理された最先端機能にはプロプライエタリモデルを選択し、チームがインフラストラクチャを管理できる場合は、制御、カスタマイズ、またはプライベート展開にはオープンウェイトモデルを選択してください。.
はい、GLM、DeepSeek、Qwen、Kimi、MiniMax はグローバルワークロードをサポートできますが、企業はアクセス、プライバシー、居住権、ライセンス、モデレーション、サポートを確認する必要があります。.
いいえ、ベンチマークは候補を絞り込むだけですが、プロンプト、ツール、データ、ワークフロー、エラー率、レビュー時間、総コストがより良いビジネス上の選択を決定します。.
いいえ、予測可能なプロセスは通常、固定自動化で処理する方が適しており、AIは解釈、判断、または適応が必要な作業で価値を発揮します。.
同一のデータ、プロンプト、ツール、権限、予算を使用して同一の実際のタスクを複数回実行し、成功、重大なエラー、レイテンシ、リカバリ、レビュー時間、コストを比較する。.
AIモデルは解釈や判断を処理でき、ワークフロープラットフォームはAIの決定に関連するトリガー、ルール、アプリケーション、承認ステップ、ログを管理します。.




 JA
 EN
 DE
 ES
 NL
 IT
 PT