Escolher entre os melhores modelos de IA para negócios em 2026 não é simplesmente uma questão de selecionar o modelo com a maior pontuação de benchmark. Uma equipe de suporte pode precisar de velocidade e baixo custo, uma equipe de software pode precisar de codificação em nível de repositório, enquanto um negócio focado em privacidade pode preferir um modelo aberto ou implantado localmente.
GPT-5.6, Claude, Gemini, Grok, GLM, DeepSeek, Qwen, MiniMax e outras famílias de modelos lideram diferentes cargas de trabalho. Alguns são mais fortes em raciocínio ou programação, enquanto outros se destacam pelo trabalho multimodal, latência, preço, uso de ferramentas ou implantação privada.
O mesmo modelo pode alimentar um chatbot, um copilot ou Agente de IA dependendo das ferramentas, memória, permissões e fluxo de trabalho construídos em torno dele. A verdadeira decisão não é apenas qual modelo é mais capaz, mas qual deles pode concluir sua tarefa com confiabilidade, segurança e a um custo total sustentável.
Este guia compara os melhores modelos de IA para negócios por carga de trabalho, evidências de benchmark, custo, segurança, opções de implantação, uso local e suporte para fluxos de trabalho de chatbot e agente de IA.
| Nota de pesquisa |
| Limite de pesquisa: 11 de julho de 2026. Aliases do modelo, acesso de visualização, preços, placares, termos de retenção de dados e disponibilidade regional podem mudar. Verifique novamente as páginas oficiais vinculadas antes da aquisição ou implantação. |
Não existe um único melhor modelo de IA para todas as empresas em 2026. A escolha mais forte depende da carga de trabalho:
O custo varia muito. No exemplo do relatório de 1 milhão de tokens de entrada mais 250.000 tokens de saída, o custo estimado apenas de tokens varia de cerca de $0,62 a $22,50, antes de pesquisa, ferramentas, novas tentativas, monitoramento ou revisão humana.
A maioria das empresas não precisa do modelo mais forte para todas as tarefas. Uma configuração roteada pode usar um modelo de menor custo para trabalho de rotina e reservar um modelo de ponta para casos difíceis ou de alto risco.
Em um cenário de suporte, o encaminhamento 80% de conversas para Gemini 3.1 Flash-Lite e os 20% restantes para GPT-5.6 Sol reduziu o custo estimado apenas para tokens de aproximadamente $275 para $66, ou cerca de 76%. A economia real depende da duração da conversa, da precisão do encaminhamento, das tentativas de repetição, das ferramentas utilizadas e da revisão humana.
Um modelo de IA é o motor de raciocínio, enquanto “chatbot” e “agente” descrevem o sistema construído em torno dele. Em um chatbot, o modelo de IA responde principalmente a mensagens. Em um agente de IA, ele é conectado a ferramentas, estado da tarefa, permissões e um loop de controle que pode impulsionar o trabalho.
Chamar uma ferramenta uma vez não torna um sistema automaticamente um agente. A mudança acontece quando ele pode escolher e sequenciar várias ações, verificar os resultados, ajustar seu próximo passo e parar ou solicitar aprovação quando necessário.
O gráfico mostra quão próximos os principais modelos de IA estão em 2026. O Claude Fable 5 está no topo com uma pontuação de 60, seguido de perto pelo GPT-5.6 Sol, com 59.
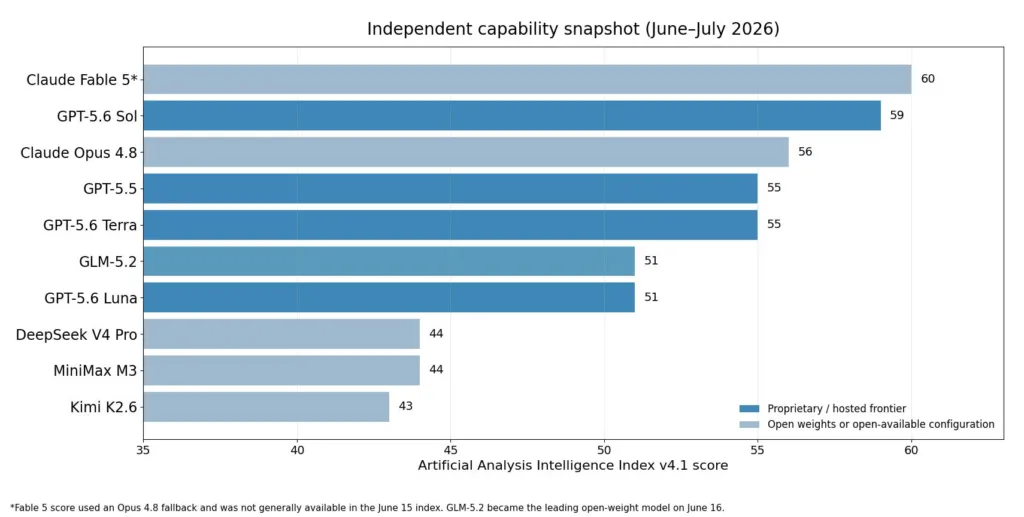
Fonte: Análise Artificial. Quanto maior, melhor.
Para uma empresa, o benchmark é mais útil como um ponto de partida. Fable 5 e GPT-5.6 Sol pertencem à lista restrita de alto desempenho.
Terra, Lua, GLM-5.2, DeepSeek V4 Pro e MiniMax M3 podem ser mais adequados quando custo, velocidade, privacidade ou flexibilidade de implantação são mais importantes do que a pontuação mais alta possível.
Benchmarks podem te direcionar, mas não devem escolher o modelo por você. A melhor opção é aquela que tem um bom desempenho no seu fluxo de trabalho real, mantém os erros baixos, reduz a necessidade de correções manuais e entrega resultados a um custo que faça sentido para o seu negócio.
Esta classificação mostra quais modelos de IA as pessoas preferiram em conversas reais, não qual modelo é objetivamente o mais preciso.
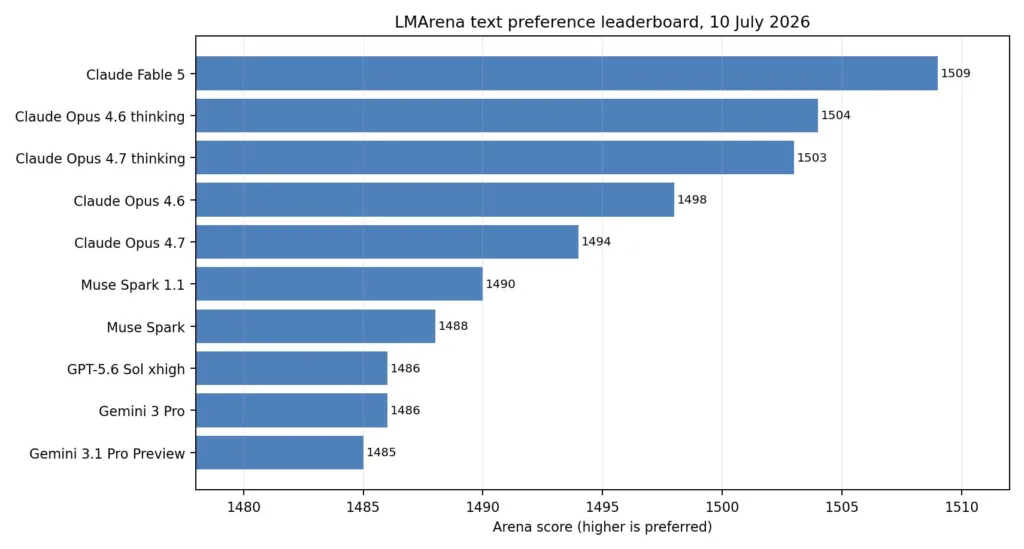
Fonte: LMArena Quadro de Líderes de Texto. A preferência humana inclui utilidade, estilo e apresentação.
No instantâneo, Claude Fable 5 liderava com uma pontuação de 1509. Várias versões do Claude Opus o seguiam de perto, enquanto GPT-5.6 Sol e Gemini 3 Pro ambos pontuaram 1486.
Para o trabalho voltado para o cliente, isso é importante. As pessoas notam se uma resposta parece clara, útil, natural e fácil de seguir. Um modelo que se sai bem aqui pode ser um forte candidato para suporte, conversas de vendas, redação ou outras tarefas voltadas para o usuário.
Mas a preferência é apenas uma parte do quadro. Uma pontuação alta na arena não prova que um modelo é mais factual, mais seguro, melhor no uso de ferramentas ou mais confiável em um fluxo de trabalho de negócios. Novos modelos também podem ter menos votos, e pequenas diferenças de pontuação podem não significar muito quando os intervalos de incerteza se sobrepõem.
A melhor maneira de usar este gráfico é identificar modelos que valham a pena testar para a experiência do cliente.
Para empresas de software, hardware ou engenharia, este resumo pode ajudar a reduzir os modelos de IA que valem a pena testar para trabalhos técnicos.
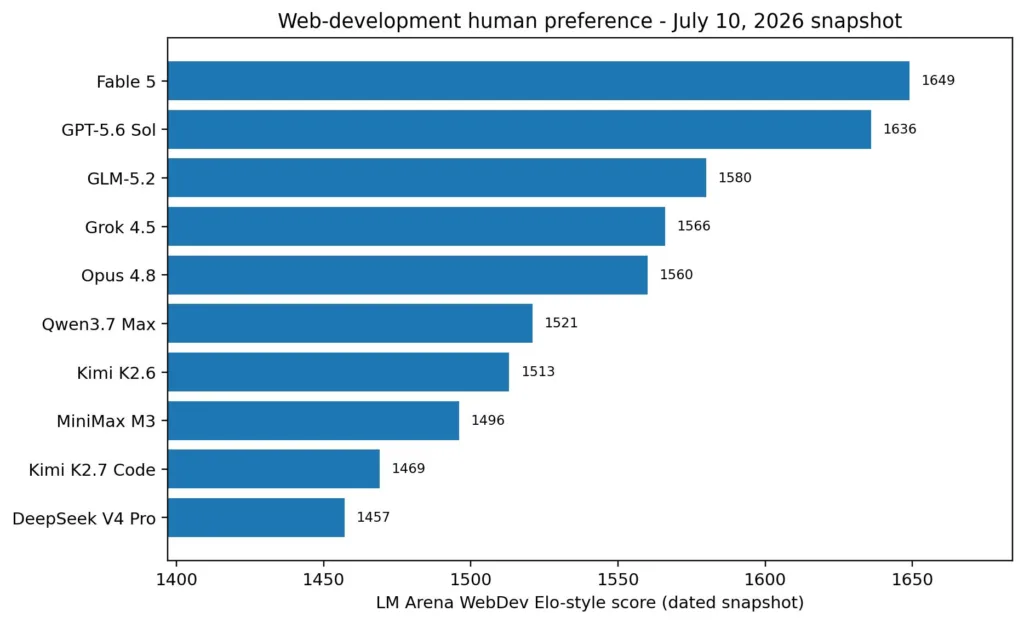
Fonte: Tabela de classificação LMArena WebDev. A linha GPT-5.6 utilizou um "harness" do Codex. A pontuação, portanto, reflete o modelo e o sistema de codificação circundante.
Nos resultados recentes, Fable 5 ficou em primeiro lugar com uma pontuação de 1649, seguido por GPT-5.6 Sol e GLM-5.2, que ficaram em terceiro lugar com 1580, à frente de Grok 4.5 e Claude Opus 4.8.
Isso torna Fable 5 e GPT-5.6 Sol fortes candidatos para tarefas de desenvolvimento complexas, enquanto GLM-5.2 merece atenção de equipes que buscam uma opção de peso aberto para codificação privada ou fluxos de trabalho de agentes.
No entanto, este não é um benchmark de engenharia completo. O resultado do GPT-5.6 utilizou um "harness" Codex, portanto a pontuação reflete tanto o modelo quanto o sistema de codificação circundante. A preferência humana também mede o quão útil e polido é o resultado final, não apenas se o código está correto, seguro ou pronto para produção.
Para empresas de software, equipes de WordPress, produtos SaaS, empresas de hardware e firmas de engenharia, o melhor próximo passo é um teste técnico privado. Compare cada modelo com o trabalho que sua equipe realmente executa, como alterações de repositório, APIs, suporte de firmware, documentação técnica, depuração, SQL, verificações de segurança, geração de testes e compatibilidade com versões anteriores.
Escolher um modelo de IA apenas pelo nome da marca é tentador, mas as empresas não compram benchmarks. Elas compram resultados.
Uma equipe de suporte ao cliente precisa de respostas rápidas e escalonamento seguro. Uma equipe de software precisa de acesso ao repositório, testes e alterações de código confiáveis. Uma empresa focada em privacidade pode se preocupar mais com a auto-hospedagem do que em vencer um placar público. É por isso que a lista mais útil começa com o trabalho que você precisa que o modelo conclua.
A tabela abaixo oferece pontos de partida práticos com base na documentação oficial do modelo, páginas de preços e evidências de benchmarks independentes. É uma lista restrita para testes, não um ranking universal.
| Necessidade de negócio | Escolhas iniciais | Melhor ajuste | Cuidado principal | Fontes-chave |
| Capacidade geral máxima | Claude Fable 5 ou GPT-5.6 Sol | Análise complexa, pesquisa de alto valor e planejamento difícil | Ambas são opções premium. Teste-as na tarefa exata antes de se comprometer. | Análise Artificial colocou Fable 5 e GPT-5.6 Sol próximos em seu Índice de Inteligência. |
| Agente corporativo equilibrado | GPT-5.6 Terra, Claude Sonnet 5, ou Gemini 3.5 Flash | Trabalho de conhecimento diário, uso de ferramentas, entrada multimodal e automação de negócios padrão | Modelos de menor custo podem precisar de escalonamento para casos difíceis ou sensíveis. | A OpenAI posiciona a Terra como seu equilíbrio GPT-5.6 tier. O Google descreve o Gemini 3.5 Flash como um modelo para trabalho agentivo de várias etapas, enquanto a Anthropic posiciona o Sonnet como seu nível de modelo balanceado. |
| Suporte e roteamento de alto volume | Gemini 3.1 Flash-Lite, GPT-5.6 Luna, ou Claude Haiku 4.5 | Classificação, extração, triagem de tickets e respostas curtas e rotineiras | Adicionar um modelo mais robusto ou revisão humana para reclamações, reembolsos e alterações de conta. | O Google descreve Flash-Lite como um modelo de baixa latência para fluxos de trabalho de alto volume. A OpenAI posiciona o Luna como seu nível de custo-benefício, e a Anthropic recomenda o Haiku para aplicações rápidas e sensíveis a custos. |
| Codificação no nível do repositório | GPT-5.6 Sol com Codex; Claude Fable ou Opus como revisor | Grandes bases de código, trabalho no terminal, testes, depuração e revisão de código | O agente de codificação circundante, as ferramentas, a política de teste e o orçamento de raciocínio podem alterar o resultado. | GPT-5.6 Sol liderou o Índice de Agente de Codificação de Análise Artificial capturado no sistema de controle Codex. |
| Documentos e mídias multimodais | Gemini 3.1 Pro ou Gemini 3.5 Flash | Fluxos de trabalho envolvendo PDFs, imagens, áudio, vídeo, arquivos e código | Verifique o endpoint exato, os custos das ferramentas, os limites de contexto e os termos de governança de dados. | Google lista Gêmeo 3.1 Pro para raciocínio multimodal complexo e Gemini 3.5 Flash para tarefas de agente e codificação em escala. |
| Implantação em empresas abertas ou privadas | GLM-5.2, Mistral Large 3 ou Command A+ | Implantações locais, em nuvem privada, soberanas ou personalizadas | Sua equipe se torna responsável pela infraestrutura, segurança, monitoramento e atualizações. | GLM-5.2 está disponível com suporte de contexto longo; Mistral Large 3 e Command A+ são lançados sob a licença Apache 2.0 para implantação privada. |
| Raciocínio aberto de baixo custo | DeepSeek V4 Pro ou V4 Flash | Raciocínio repetido, codificação, chamadas de ferramentas e tarefas de agente sensíveis a custos | Os modelos ainda são muito grandes para auto-hospedar, e o acesso regional ou os termos de dados exigem revisão. | DeepSeek's o lançamento oficial descreve V4 Pro e Flash como modelos de raciocínio e agente de contexto longo, com o Flash projetado como a opção menor e mais barata. |
| Fluxos de trabalho de negócios chineses e ingleses | Qwen3.7 Max, GLM-5.2, Kimi K2.6, ou DeepSeek V4 | Trabalho de escritório multilíngue, codificação, tarefas de contexto longo e fluxos de trabalho baseados em ferramentas | Verifique o acesso ao endpoint internacional, as versões do modelo, a residência, a moderação, o faturamento e o suporte. | Alibaba recomenda Qwen3.7 Max para tarefas complexas de vários passos. Z.ai, Kimi e DeepSeek demonstram capacidades agenticas, de codificação e de longo alcance. |
| Assistente de estação de trabalho local | Qwen3-Coder, Gemma 4 12B, Ministral 3 14B, ou Devstral Small 2 | Repositórios privados, documentos offline, codificação local e redução da exposição na nuvem | O desempenho real depende de RAM, memória da GPU, quantização, tamanho do contexto e suporte em tempo de execução. | Qwen3-Coder O Gemma 4, que é compatível com codificação em escala de repositório, inclui um modelo aberto de 12B, o Ministral 14B é otimizado para uso local e o Devstral Small 2 visa agentes de engenharia de software locais. |
A escolha certa depende da carga de trabalho específica que sua empresa precisa lidar. Opções de menor custo, como Gemini Flash-Lite, GPT-5.6 Luna, e Claude Haicai pode lidar com suporte rotineiro, triagem de tickets e tarefas simples de dados.
Para vendas, atualizações de CRM e operações diárias, Terra, Soneto, e Gemini Flash oferece um melhor equilíbrio entre capacidade, velocidade e custo.
Trabalhos mais exigentes, como desenvolvimento de software, pesquisa técnica ou análise de documentos longos, podem precisar GPT-5.6 Sol, Claude, Gemini Pro, GLM-5.2, ou Qwen3-Coder. Equipes com necessidades de privacidade mais rigorosas também podem explorar opções de código aberto ou auto-hospedadas.
A maioria das empresas não precisa de um modelo para tudo. Uma configuração mista geralmente funciona melhor: use um modelo de menor custo para o trabalho rotineiro, envie casos difíceis para um modelo mais robusto e mantenha a aprovação humana antes de reembolsos, alterações de conta, mensagens externas ou outras ações sensíveis.
Empresas que desejam comparar assistentes de IA completos, e não apenas seus modelos subjacentes, podem explorar nosso guia para melhores alternativas ao ChatGPT.
Sim. Modelos de IA de peso aberto podem ser executados em um laptop, estação de trabalho ou servidor privado. Para transformar um modelo de IA local em um agente de IA local, você adiciona um runtime de agente, memória privada ou RAG e acesso controlado a ferramentas como arquivos, navegadores, terminais ou aplicações de negócios.
A principal vantagem é o controle. Arquivos confidenciais e repositórios privados podem permanecer dentro do seu ambiente. A figura mostra como as solicitações do usuário passam por um agente local em tempo de execução para um modelo local, índice de conhecimento privado e ferramentas isoladas.
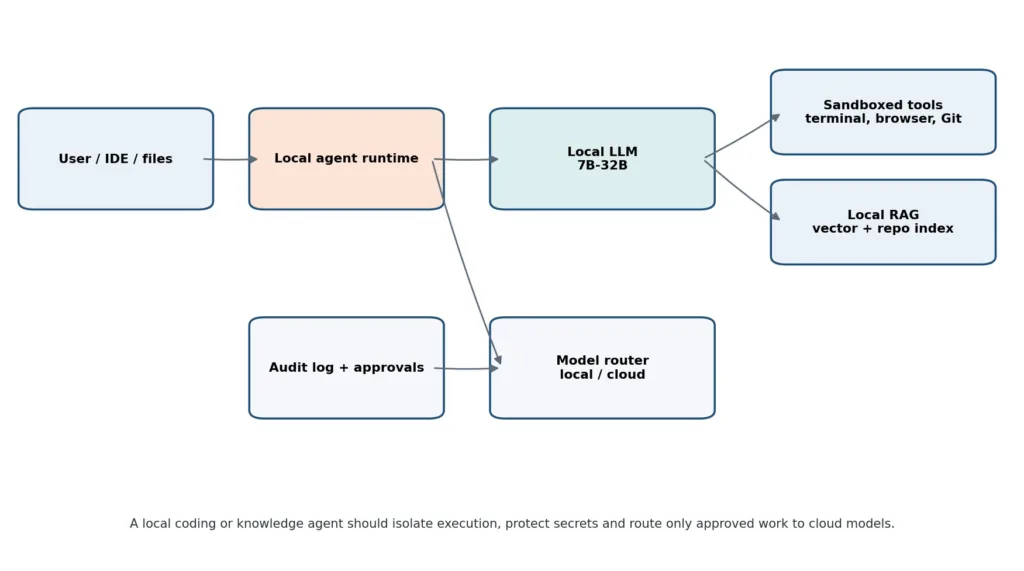
Fonte: projeto llama.cpp. Mantenha o acesso ao repositório local, isole a execução do terminal e do navegador e envie apenas o contexto aprovado para um fallback na nuvem.
Vários modelos se encaixam nesta configuração. Gemma 4 12B e Ministral 3 8B ou 14B são opções práticas para busca de documentos, assistentes privados e uso geral de ferramentas.
Devstral Pequeno 2 24B é projetado para trabalho de codificação baseado em repositório, enquanto menores Qwen modelos podem suportar codificação local e tarefas em chinês-inglês. Granito 4.1 8B ternos do setor privado, pesquisa e RAG, e Phi-4 Reasoning Vision 15B pode lidar com documentos, imagens e tarefas relacionadas à interface.
Modelos menores como Gemma 4 E2B/E4B ou Llama 3.2 1B/3B pode rodar em telefones ou dispositivos mais leves para trabalhos offline simples.
A escolha certa depende de RAM disponível, memória da GPU, quantização de modelos, comprimento de contexto e a velocidade que sua equipe espera. Modelos menores são mais fáceis de executar, enquanto o trabalho de codificação e documentos longos pode exigir uma estação de trabalho mais potente.
A implantação local mantém dados sensíveis sob seu controle, mas ainda requer acesso seguro às ferramentas, atualizações, monitoramento, logs de auditoria e sandboxing.
Para muitas empresas, uma configuração híbrida funciona melhor: mantenha o trabalho privado e rotineiro localmente, e envie apenas tarefas aprovadas e difíceis para um modelo de nuvem.
O preço da API pode parecer simples, mas é apenas o ponto de partida. Uma carga de trabalho de negócios também pode usar pesquisa na web, sessões de navegador, sandboxes de código, bancos de dados vetoriais, ferramentas externas, novas tentativas, modelos de fallback, monitoramento e revisão humana.
É por isso que as empresas devem medir o custo total por tarefa bem-sucedida, não apenas o preço por milhão de tokens.
O gráfico abaixo usa um exemplo compartilhado: 1 milhão de tokens de entrada mais 250.000 tokens de saída. Sob essas suposições, o custo estimado apenas de tokens varia de $0.62 com Gemini 3.1 Flash-Lite para $22.50 com Claude Fable 5, uma diferença de mais de 35 vezes.
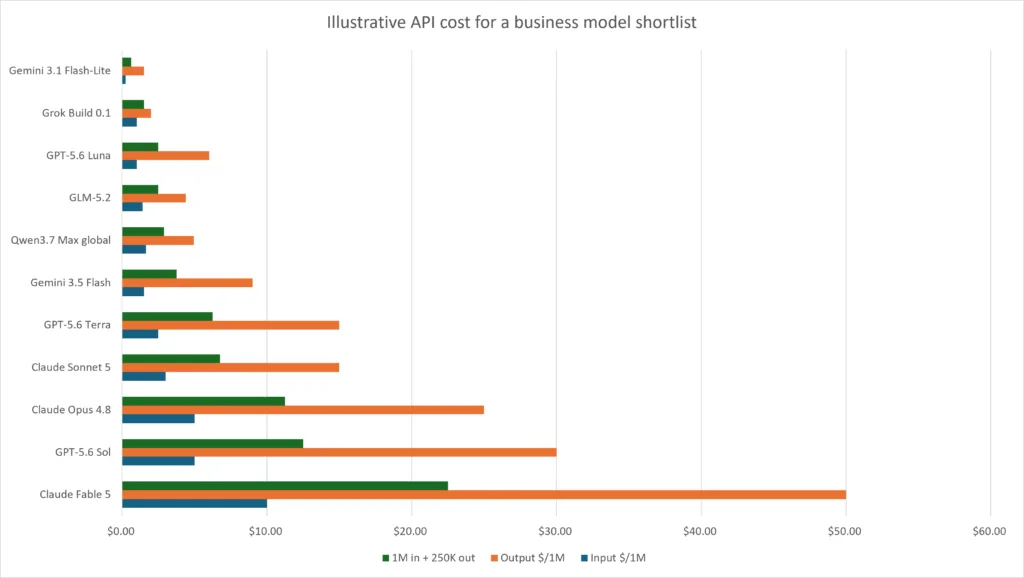
A tabela de preços acima usa taxas oficiais do provedor, não cotações de um fornecedor.
Um exemplo recente de um usuário oferece outro sinal útil: o desenvolvedor Dax relatou que o Claude Fable foi responsável por cerca de 30% do custo do modelo de sua equipe, mesmo que a captura de tela mostrasse um uso muito menor do que o GPT-5.6 Sol. Sam Altman destacou posteriormente essa diferença em uma resposta.
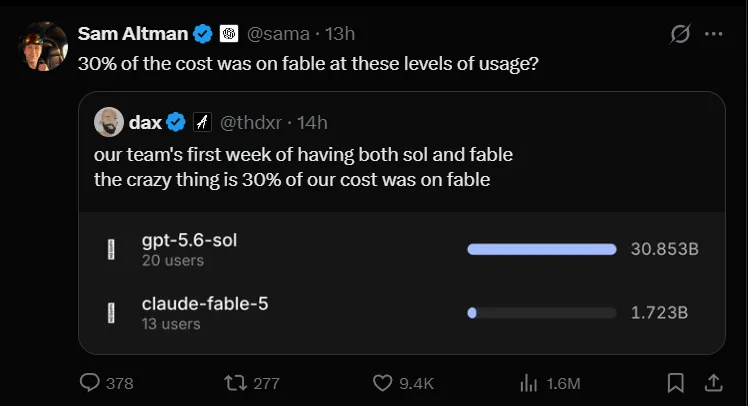
Este exemplo deve ser tratado como observação pessoal, não um benchmark controlado. Os dois modelos podem ter lidado com tarefas, prompts, comprimentos de saída, configurações de raciocínio ou cargas de trabalho diferentes.
No entanto, reforça um ponto importante: preço por token e uso podem criar contas muito diferentes. Compare modelos usando as mesmas tarefas e meça o total custo por resultado bem-sucedido, incluindo novas tentativas e revisão humana.
Nem todo processo de negócios precisa de IA. Se as etapas são previsíveis, a automação fixa geralmente é mais rápida, barata e fácil de controlar. A IA se torna valiosa quando o fluxo de trabalho requer interpretação, julgamento, mudanças de decisão ou o manuseio de situações inesperadas. Antes de escolher um chatbot, agente ou modelo, pergunte se a IA melhorará um resultado mensurável, como tempo de resposta, precisão, qualidade de leads ou trabalho concluído. Se for apenas para substituir alguns cliques, a automação pode ser suficiente.
Ao comparar os melhores modelos de IA para negócios, a escolha certa não é simplesmente aquela que vence mais benchmarks. É o modelo que completa sua carga de trabalho real com segurança, confiabilidade e a um custo que seu negócio pode sustentar.
Fable e GPT-5.6 Sol pertencem à lista de finalistas da fronteira. Terra, Sonnet, Gemini Flash, Luna e Flash-Lite oferecem mais controle sobre os custos cotidianos. GLM, DeepSeek, Qwen, MiniMax, Mistral e Command A+ oferecem mais flexibilidade para implantação aberta, privada, local e regional.
Comece com uma carga de trabalho definida. Mantenha etapas previsíveis baseadas em regras, forneça ao modelo apenas as ferramentas de que ele precisa e exija aprovação humana antes de ações sensíveis. Em seguida, meça o sucesso da tarefa, erros, tempo de revisão, velocidade e custo total por resultado concluído.
Para equipes que desenvolvem fluxos de trabalho de automação ou de agentes de IA, plataformas como a Bit Flows podem conectar modelos de IA selecionados a gatilhos, regras de negócios, aplicativos, aprovações e registros. O objetivo não é adicionar IA a todas as etapas, mas utilizar o modelo certo apenas nos casos em que a interpretação ou o julgamento geram valor real.
Não há um vencedor único; o melhor modelo de IA para negócios depende da carga de trabalho, orçamento, requisitos de privacidade, ferramentas, método de implantação e taxa de erro aceitável.
GPT-5.6 Terra, Claude Sonnet 5 e Gemini 3.5 Flash são pontos de partida práticos para trabalho de conhecimento diário, tarefas de CRM, conteúdo e automação de negócios.
Gemini Flash-Lite, GPT-5.6 Luna e Claude Haiku atendem suporte rotineiro, enquanto reclamações, reembolsos e alterações de conta devem ser direcionados a um modelo mais robusto ou a um revisor humano.
ChatGPT Sol e Claude Opus são fortes candidatos para trabalhos complexos em repositórios, enquanto GLM-5.2 e Qwen3-Coder oferecem opções de peso aberto para fluxos de trabalho de codificação privados.
Gemini Pro e Gemini Flash são ótimos pontos de partida para fluxos de trabalho multimodais envolvendo documentos, imagens, áudio, vídeo, arquivos e código.
Sim, o mesmo modelo pode potencializar um chatbot, um copiloto ou um agente de IA, dependendo das ferramentas, memória, permissões e fluxo de trabalho construídos em torno dele.
A maioria das empresas se beneficia do roteamento de modelos, usando modelos de menor custo para trabalhos rotineiros e modelos mais robustos ou revisão humana para casos complexos, incertos ou sensíveis.
O custo total inclui tokens, pesquisa, ferramentas, armazenamento, sandboxes, novas tentativas, monitoramento e revisão, portanto, as empresas devem medir o custo por tarefa bem-sucedida.
O custo total inclui tokens, buscas, ferramentas, sandboxes, armazenamento, novas tentativas, monitoramento e revisão humana, portanto, as empresas devem comparar o custo por tarefa bem-sucedida em vez de apenas o preço do token.
Sim; modelos open-weight podem rodar localmente, modelos quantizados de 7B a 32B podem suportar documentos locais, codificação, recuperação e ferramentas menores, embora hardware, segurança, atualizações, comprimento de contexto e desempenho em tempo de execução ainda importem.
Escolha modelos proprietários para capacidade de ponta gerenciada e modelos de peso aberto para controle, personalização ou implantação privada quando sua equipe puder gerenciar a infraestrutura.
Sim, GLM, DeepSeek, Qwen, Kimi e MiniMax podem suportar cargas de trabalho globais, mas as empresas devem verificar acesso, privacidade, residência, licenciamento, moderação e suporte.
Não, benchmarks criam uma lista de pré-selecionados, mas seus prompts, ferramentas, dados, fluxo de trabalho, taxa de erro, tempo de revisão e custo total determinam a melhor escolha de negócios.
Não, processos previsíveis geralmente são melhor gerenciados com automação fixa, enquanto a IA agrega valor quando o trabalho requer interpretação, julgamento ou adaptação.
Execute tarefas reais idênticas com os mesmos dados, prompts, ferramentas, permissões e orçamentos, em seguida, compare o sucesso, erros graves, latência, recuperação, tempo de revisão e custo.
Modelos de IA podem lidar com a interpretação ou o julgamento, enquanto plataformas de fluxo de trabalho gerenciam gatilhos, regras, aplicativos, etapas de aprovação e logs em torno da decisão de IA.



 PT
 EN
 DE
 ES
 NL
 IT
 JA